一千块的库存笔记本,逼我自己写了个输入法
我花一千块买了一台库存全新的笔记本,装的是 ChromeOS。价格是好事,系统是生地方。
真正把我卡住的不是系统,是打字。我平时写代码、写稿子,习惯用豆包输入法口喷:想到哪说到哪,一句能说四十个字,术语和口语混在一起,说完停一拍它就上屏了。这套习惯用了很久,快过键盘。但在 ChromeOS 上,它没有地方安放——没有豆包,也没有任何一个能顶上的。
我花了两个晚上把能找到的方案试了一遍:ChromeOS 系统自带的输入法没有语音输入;浏览器应用市场里的几个语音工具,基本都面向英文场景设计,中文断句和标点一团糟,安装之后还得在好几个页面里来回配,效果仍然一般;还有一部分要么依赖联网(口喷的内容得上云),要么用几次就提醒你升级付费。三个条件凑不齐:中文能说、本地能跑、拿来就能用。
那就不凑了,自己做一个。叫 CrostiVoice。这篇是这个方案的完整拆解:交互怎么设计、三层文本处理管线怎么排布、踩了哪些 MV3 的坑,以及——为什么一个人现在能把这件事做完。
第一个坑:长按搜索键走不通
ChromeOS 笔记本的键盘上有个搜索键(Everything Button)。我第一反应就是拿它做语音键——安卓上「按住说话」的心智直接平移过来,最自然。真机试完就放弃了:长按搜索键是系统级手势,固定呼出 Assistant,扩展拿不到这个事件。这个交互在系统层面就不存在。
退一步的方案反而更稳:点一下搜索键开始说话,说完停顿约 1.6 秒自动断句上屏,再点一下立即结束。静音自动结束看着是妥协,实际用起来比按住松开顺手——口喷的时候往往是边想边说,谁也不想一直按着个键。识别浮层用 Shadow DOM 做在页面右下角,实时显示中间结果;文字落到光标所在的位置,input、textarea、contenteditable 三类都接。
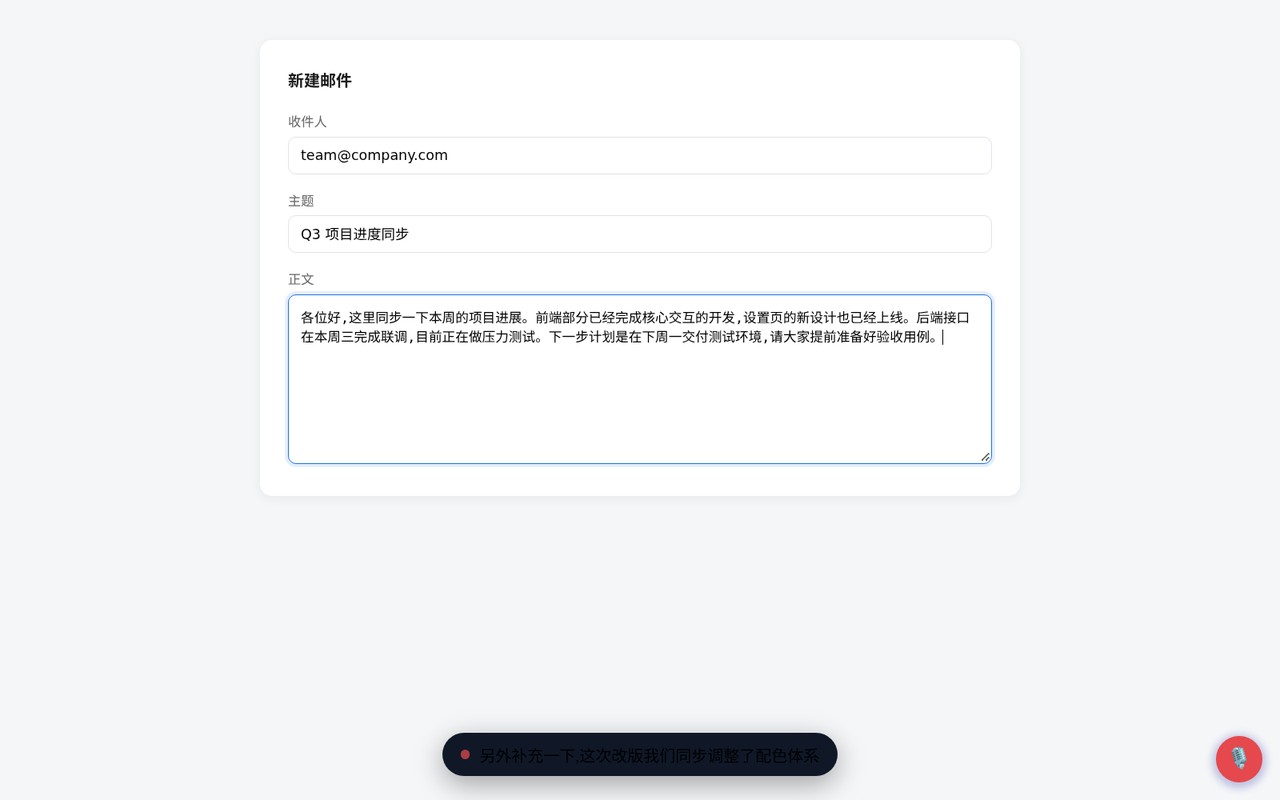
文字注入,坑比想象多
识别出来的文字怎么进输入框?最直接的做法是直接改 value。React 页面第一个不认:React 受控组件监听的是 input 事件,value 改了、状态树不动,界面纹丝不动。所以每一条都得走正路:先用原生 setter 赋值,再补一个冒泡的 InputEvent,让框架的状态机跟着走。
contenteditable 是另一个世界。Google Docs、飞书这类页面有自己的 undo 栈,直接插 DOM 会把撤销历史搅乱,得用 execCommand 走页面自己的编辑通道——它挂着「已废弃」的牌子,但在「往别人家页面里插字」这件事上,到现在还没有替代品。焦点跟踪也得自己做:扩展在后台记着用户最后停留的输入框,浮层一结束就把文字送去那里。少这一步,「纯语音」就破功了——每次都得先点一下输入框。
识别只是原料:三层文本处理管线
中文语音识别的原始输出,是「然后我发现了一个问题但是不确定是不是它」这样的无标点长串。真正决定可用性的是之后的处理。这里分了三层,按成本从低到高叠,任何一层不可用就降级到下一层,保证输入永远能出去。
第一层,本地规则引擎,永远在线。连接词切分(「然后」「但是」「所以」处断句补标点)、语气词定句读、口述标点(说「逗号」出逗号,说「换行」出换行)、中英混排自动加空格。零下载零延迟,处理不了复杂句式,但保证下限。
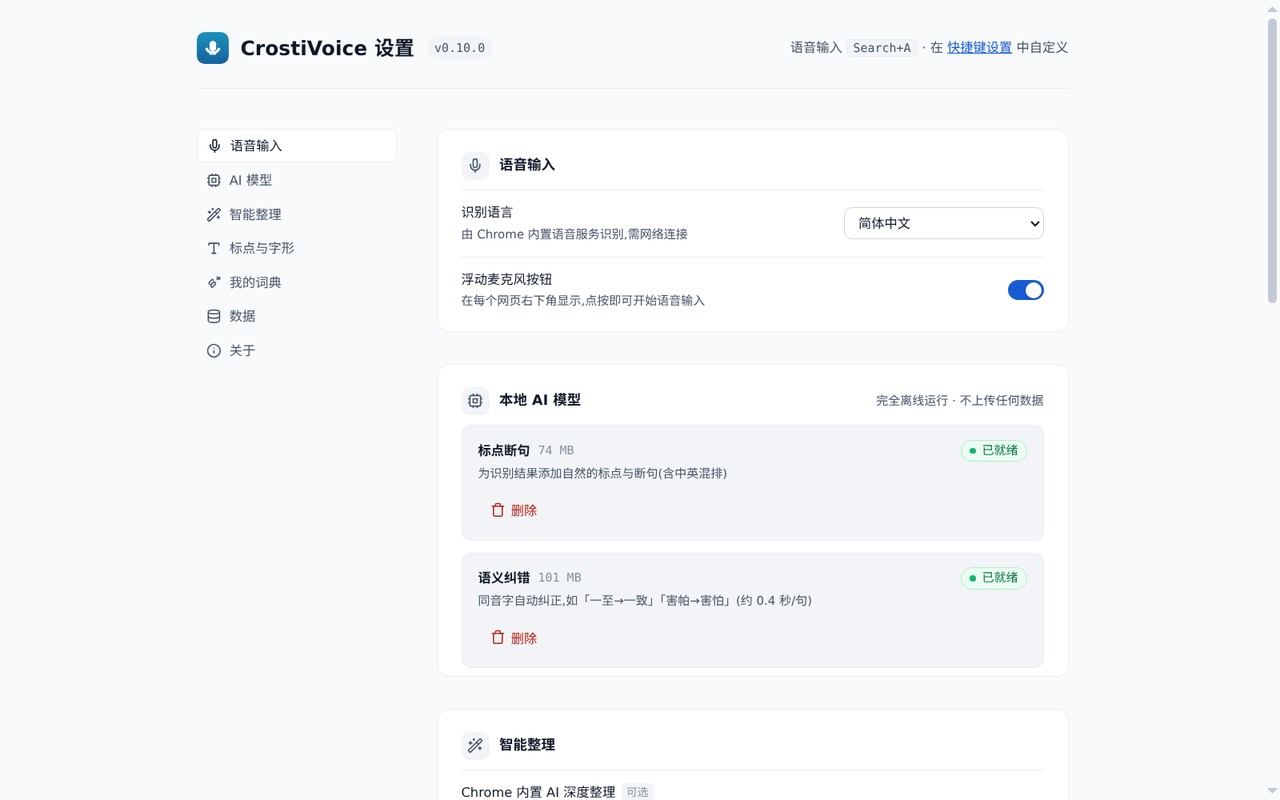
第二层,本地神经模型,可选下载。标点用 CT-Transformer,74MB;纠错用 macbert4csc,101MB,专治同音字——语音输入最高频的错误就是同音字,而写代码时这些错误很致命:「帐户」变「账户」能读过去,变量名错一个字就是运行时报错。两个模型都缓存在本机,离线运行,标点毫秒级,纠错单句约 0.4 秒,串联成「标点→纠错」管线。代价也诚实:合计 175MB,所以设计成设置页里点一下才开始下载,不预埋。
第三层,Chrome 内置 AI(Gemini Nano),做深度整理:删口癖、重组口语、合并多个识别候选,输出书面文字。它是唯一调大模型的层级,但只做「整理」,不做「识别」。这一层默认关着——它和第二层是两种品味:要「我说的,只是干净了」用本地模型;要「帮我说利落」,再开它。
热词词典:写代码场景的刚需
识别引擎不认识你的人名、项目名和技术术语,这是所有语音输入的通病。通用方案是热词补偿,做进设置页的形态借了输入法的思路:维护一张「错误识别 → 正确写法」的映射表,识别结果过一遍替换。写码场景里这张表比平时更值钱:项目名、框架名、自己造的变量名,识别引擎拆得七零八落,配几条规则就能整段正确。词典跟着配置一起 JSON 导入导出,换设备一次性带走。
坑单:哪些事和想的不一样
Web Speech 识别的坑单比代码本身还长。连续模式下遇静音会自己停,得边听边重拉识别,和静音计时器一起管理,才算真正「连续听写」。识别跑在浏览器进程的内部通道上,扩展的 Service Worker 睡眠、Offscreen Document 的生命周期,全都得绕。最费解的一条:Offscreen Document 里禁用 file://,调试时要本地起个 http.server 再连——一个纯前端项目,测试设施比项目本身先写完。
数据面是刻意的:识别在本地、模型在本机、历史记录只存最近 50 条,无遥测无账号。这不是洁癖,是场景约束——输入法里流过去的东西什么都可能有,口令、地址、内部项目名,这类数据压根不应该离开设备。市面上的云端方案未必有坏心,但「口喷的每一句都上云」这个前提,我不想要。
一千块,和一个拼图时代
装好之后的第一周,这台一千块的笔记本才真正开始工作。写代码的流程变成了:想清楚一段逻辑,开口说完,看屏幕上的字,然后动手改。它替代不了键盘——精确修改、重命名、敲命令,键盘仍然是对的答案。它替代的是「从想到字」的那一段:把一句话变成一个能编辑的草稿,剩下的交给键盘。
更大的感受在工程侧。三年前,「语音输入法」是大厂输入法团队的活:识别、标点、纠错,每一环都是重工程。现在识别在浏览器里,标点和纠错是 100MB 级的开源模型,深度整理浏览器自带。拼图都在,缺的是拼的人。一个人把现成的部件拼起来,就是一个自己够用的输入法——不是能对标大厂的输入法,是能把一件事做完的输入法。这大概是独立开发在这个时代最划算的地方。
← 返回博客列表 · 相关阅读:九年前我设计了这套开放平台 API,九年后 AI 替我调用了它 · 我的记忆库差点变成垃圾场:五条写入纪律救了它