把安全运营外包给 Agent:我用一台 NAS 搭了个家庭安全中枢
先交代来龙去脉。我家里的设备不少:一台飞牛 NAS 当存储和容器中枢,一台装了 4090 的 Linux 工作站跑 AI 推理,两台 ARM 架构的算力节点,再加上路由器和随时进出网的手机笔记本。以前我对"家里安全"的全部认知就是路由器后台看一眼有没有陌生设备——直到有一天我想明白一件事:家里跑着十几个对局域网开放的 Web 服务,我连"谁在登录、谁在跑什么进程"都答不上来。
企业里这个问题由 SIEM(安全信息与事件管理)解决,但家用方案基本空白:消费级路由器的日志看不懂也不会留存,云上的安全服务要订阅费还不让数据出门,开源的 ELK 栈功能够但门槛劝退。我的解法是三板斧:Elastic Security 落在 NAS 上做底座,Agent 做日常运营,邮件做唯一通知通道。这篇文章是完整的搭建复盘,架构图、真实告警邮件截图、自动化接管的实拍、踩过的坑,全都在下面。
一、整体架构:中枢 + 端点 + Agent 三层
整套系统的物理载体就是一台飞牛 NAS(fnOS,Debian 系),用 docker compose 跑三个容器:
| 组件 | 作用 | 端口 |
|---|---|---|
| Elasticsearch 9.2.8 | 日志与事件存储、检索引擎 | 19200 |
| Kibana(中文) | 分析面板、规则管理、告警中心 | 15601 |
| Fleet Server | 端点 Agent 的注册与管理通道 | 18220 |
端点侧装 Elastic Agent + Elastic Defend(端点防护),采集进程、网络、认证、文件事件回传 ES。目前接入了 5 个节点:NAS 本机、GPU 工作站、两台算力仓、一台 Arch 虚拟机。
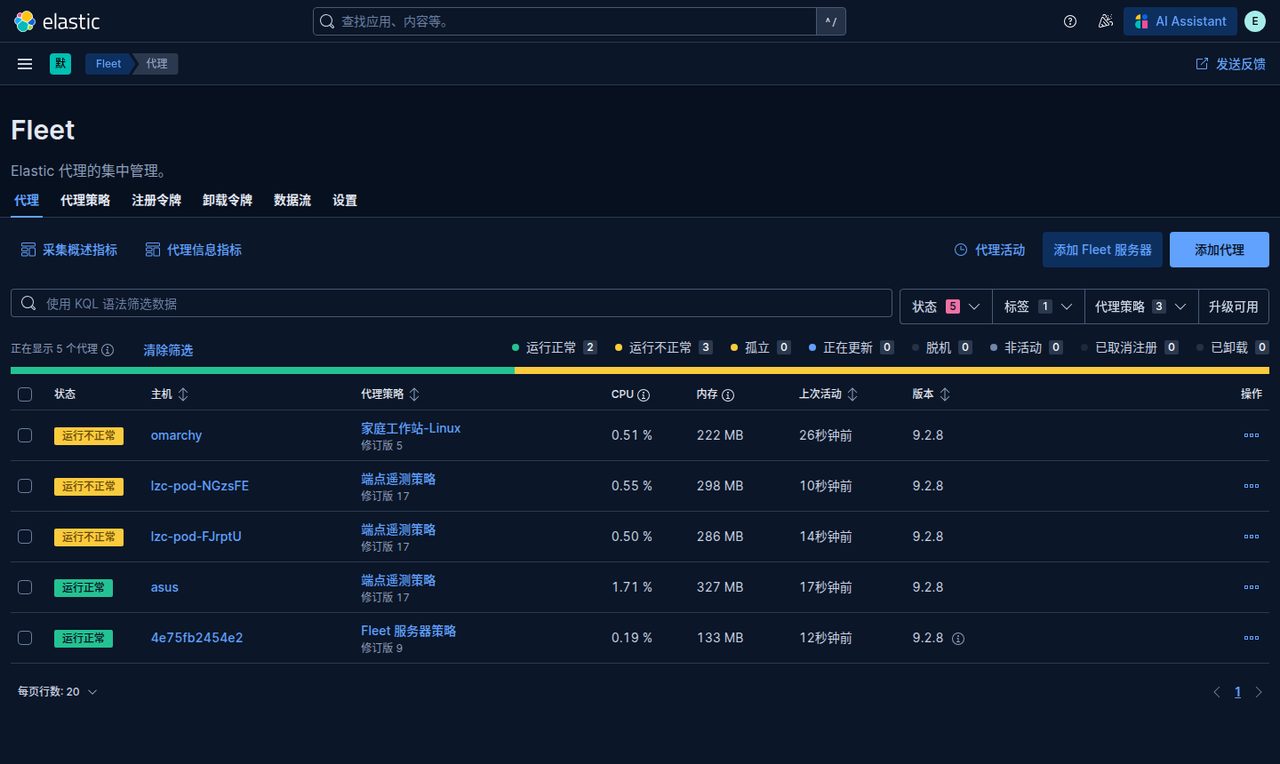
路由器也没放过:OpenWrt 的 syslog 通过 UDP 转发到 NAS 上的接收容器,解析后进 ES。SSH 登录、防火墙拦截、DHCP 分配全量留存。再自建一个威胁情报(TI)源——每 6 小时从 CINS Army、Feodo、URLhaus 等公开渠道拉取约 4.9 万条恶意 IP/URL 指标,与出站连接和 SSH 来源做撞库匹配。
二、检测规则:1150 条预置规则,家庭场景要自己"调教"
Elastic 官方规则库有 1795 条检测规则,我筛出端点相关的约 1150 条批量启用(云平台规则全部停用避免空转)。Basic 许可免费含全部查询型规则,这也是选它的重要原因——全套能力零许可费,数据不出家门。
但预置规则是为企业环境设计的,直接开跑的后果是误报轰炸。第一天的告警里,我逐条判读出了这些家庭特有的误报:
| 告警特征 | 真实原因 | 处置 |
|---|---|---|
| Web 服务器子进程异常 | AI 生图业务里 Python 调度 docker 的正常链路 | 加白 |
| 内核模块污染 | NVIDIA 驱动加载 GPU 模块 | 加白 |
| LD_PRELOAD 注入 | PyTorch 的 CUDA 运行时检测 | 加白 |
| 网络连接发现类命令 | 我自己的巡检脚本跑 ps/netstat | 加白 |
加白不是在面板上点一下就完事。Elastic 的例外列表 API 有不少坑(条目值必须是标量、挂载规则时要 id 和 list_id 双键同传),我在 GPU 工作站上真实触发了一次误报模式、确认事件已入库但告警为零,才算这条白名单真正生效。刻意不加白的是 SSH 异常来源 IP 和用户创建——这两个是真实信号通道,新 IP 登录必须让我看见。
三、Agent 自动化:告警判读、巡检报告、邮件接管
规则跑起来之后,新的问题变成了"谁来看"。企业有安全运营团队三班倒,家里只有我。答案是把日常运营交给 Agent,我只保留两件事:看结论,做决策。
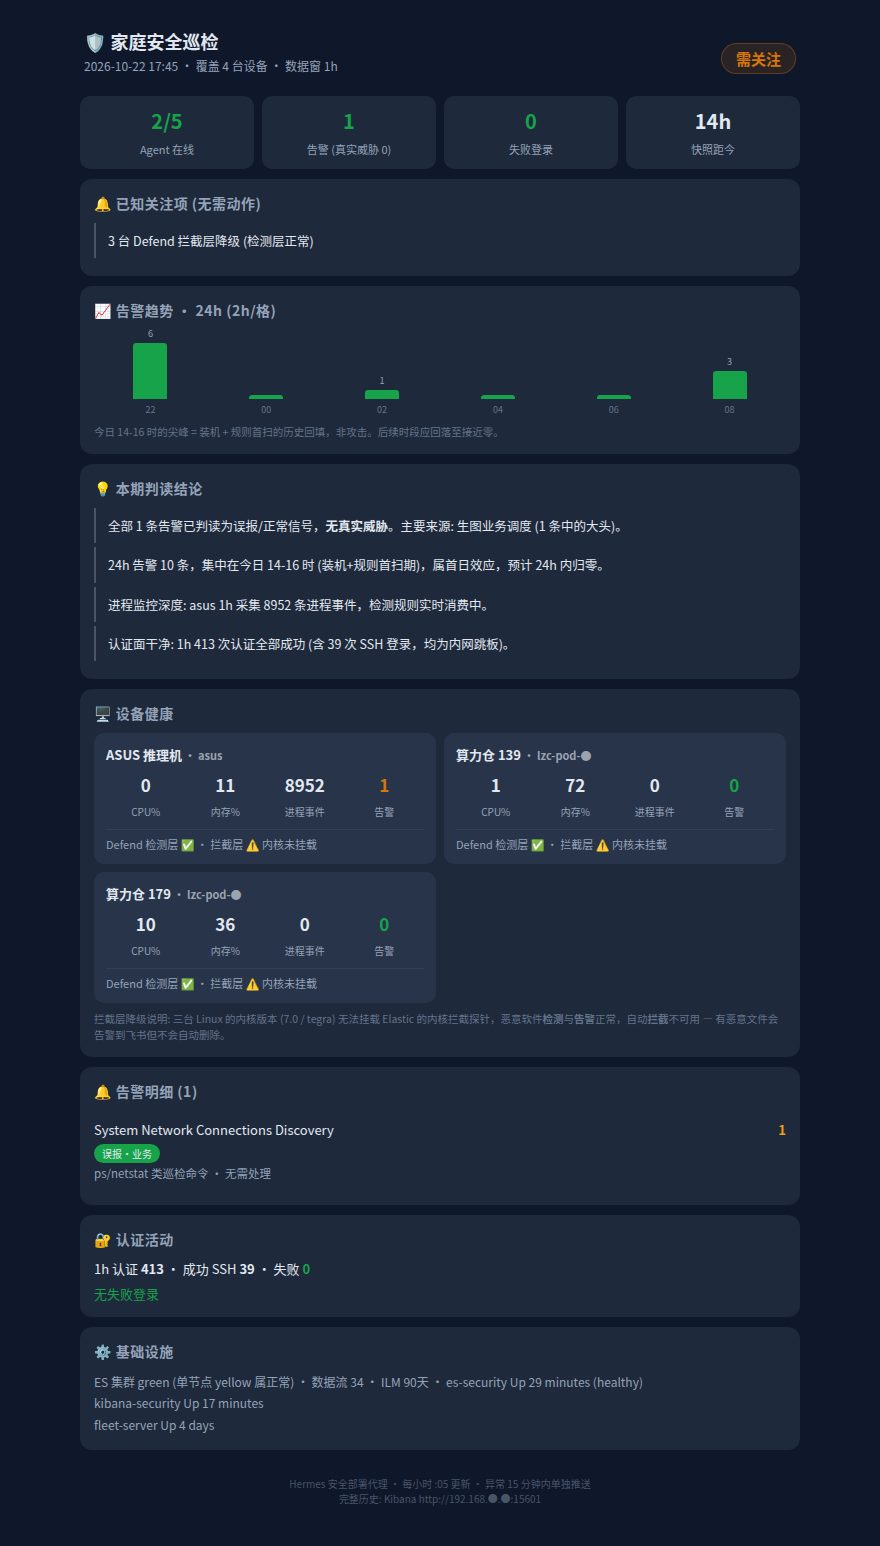
每小时巡检 + 全绿静默
Agent 每小时巡检一轮:agent 在线数、告警数、失败登录、快照新鲜度、日志断流。判定"全绿"就静默——只在 NAS 上刷新一份 HTML 报告随时可看,不发任何通知。任何一项破功,推送才发。这条"没有异常就不要打扰我"的原则是整个系统的灵魂:告警通道的信任是稀缺资源,被日常噪音透支过的通道,真出事时没人看。
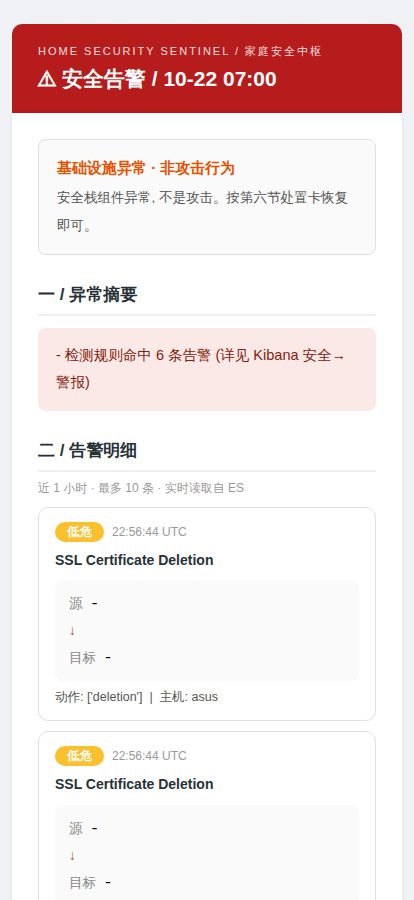
异常时的分析型告警邮件
真正触发推送时,Agent 发的不是"出事了快来看"的干嚎,而是一封自带分析结论的邮件:告警定性(测试/真实/需确认三色横幅)、告警明细卡片、攻击链路还原、影响评估、分步骤行动指引。设计原则是邮件必须是终点,不是"转面板看"的入口——在手机上读完这封邮件,你就知道发生了什么、要不要处理、怎么处理。
回信即接管
最实用的一个设计:收到告警邮件后,直接回复这封邮件,Agent 就会接管排查。
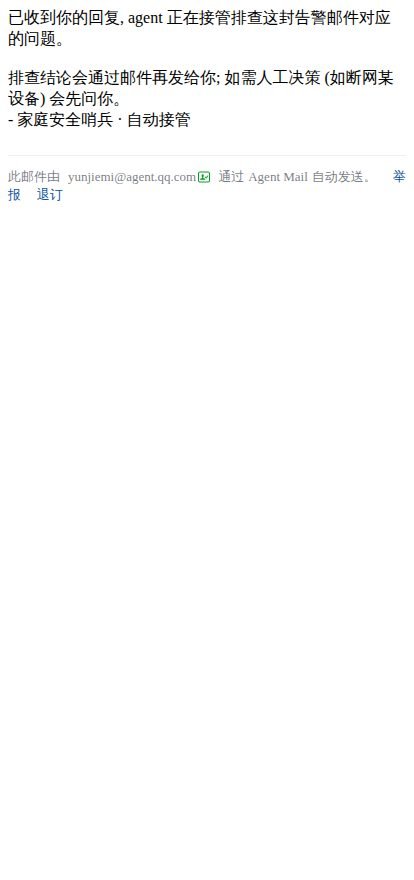
链路是:邮件监控脚本每 2 分钟扫描一次收件箱 → 识别到我的回复 → 秒级回执 → 拉起一个独立的无头 Agent 会话接管排查(查 ES 原始事件、还原链路、定性)→ 结论以同样风格的邮件回给我。整个闭环实测三轮端到端验证,从回信到结论文到达稳定在 4-5 分钟。
四、实战数据:这套系统两周里干了什么
部署两周,几个真实数字:
- 采集量:GPU 工作站高峰期每小时 8952 条进程事件,全链路认证事件一小时 413 条,全部入 ES 可检索
- 检测:24 小时窗口内 10 条告警,全部判读为误报或历史回填(装机当天规则回扫旧日志产生),真实威胁 0
- TI 撞库:自建的 4.9 万条情报源已跑通端到端验证——注入一条含恶意 IP 的出站日志,5 分钟内规则命中、告警邮件到达、定性为测试事件
- 误报治理:累计加白 5 类业务模式,全部经过"真实触发 + 事件在库 + 告警为零"的闭环验证
五、踩过的坑(想复刻的先看这节)
这套系统没有一个环节是一遍跑通的。把最狠的几个坑列出来,能帮你省下我花掉的大部分时间:
1. Fleet 的"假在线"。Agent 注册成功、组件全绿、但数据一条都不来——原因是 Fleet 初始化后的默认 output 指向 localhost,Agent 在往自己的回环地址写数据。必须手动改成 ES 的实际地址。这个坑的可怕之处在于所有健康指标都是绿的。
2. 采集失败的"岁月静好"。查询接口用错 HTTP 方法(GET 带 body 会被 405 拒绝),异常又被脚本吞掉,巡检报告会安静地显示"告警 0 / 事件 0"——看起来特别安全,实际是采集全灭。防御是给所有"不可能为零"的组合加哨兵:agent 在线但进程事件一小时为零,直接判采集故障告警。
3. ARM 算力节点的拦截层降级。Elastic Defend 在两台 ARM64 算力仓上,检测和遥测完全正常,但内核拦截探针挂载失败(内核符号缺失)。这不是 bug 是平台边界——处理方式是计入"已知降级"基线,报告里注明,不天天告警。Linux 端点防护默认是 detect 模式(只告警不拦截),家庭场景起步这个模式刚好。
4. 邮件要在手机上看。第一版告警邮件用表格排明细,在 414px 宽的手机上规则列逐字竖排。邮件客户端不支持媒体查询,所有结构化数据一律改卡片式堆叠。
5. 快照脚本权限静默丢失。一次覆盖部署后 shell 脚本丢了执行位,cron 静默失败,快照停在昨天。巡检里从此多了一项:除了看快照时间戳,还要抽查快照日志尾部的错误行。
六、成本与边界
钱上几乎免费:Elastic Basic 许可 0 元(含全部查询型规则和 Defend),三个容器加 agent 的资源占用——ES 堆内存 2GB,agent 每节点 250-400MB 内存、CPU 低于 5%,对 NAS 和推理机都无感。真正的成本是搭起来那几天的调试时间,以及持续运营中的误报治理——这部分我外包给了 Agent,这就是这套系统里"自动托管"四个字的实际含义。
边界也说清楚:单节点部署没有高可用;ARM 节点拦截层降级(前述);威胁情报源是公开免费渠道,质量不如商业源;且整套系统的判读逻辑基于我家的设备清单和业务模式,换一个环境需要重新调教误报库。它不是企业 SOC 的替代品,是"一个人的家庭安全运营"能到达的形态。
写在最后
回看这套系统,最有价值的产物其实不是那块 Kibana 面板——面板我一个月打开不了几次。真正改变体验的是那封"收到告警、回一句话、五分钟后拿到结论文"的邮件闭环:安全从一件"想起来才检查"的事,变成了一个随时在线、主动汇报、可被问责的托管服务。
家里有 NAS 或者多余算力的朋友,这套方案的起步门槛比想象中低:一台能跑 Docker 的机器,一个下午的时间部署底座,然后让 Agent 接管剩下的运营。文中提到的坑我都踩实了,照着避就能省下大半时间。有问题欢迎邮件交流,地址在关于页。
← 返回博客列表 · 相关阅读:自托管家庭算力:一台 NAS 的进化史