把家用摄像头改造成 AI 语音管家:全链路踩坑实录
家里有一颗带云台、带麦克风、带喇叭的家用摄像头(联咏 NT98566 方案,0.7T NPU),手头有 NAS、两台 Jetson Thor 算力仓和一台常驻的微服沙箱。我想做的事很直接:让这颗摄像头变成全本地的家庭 AI 管家——能看(视觉理解)、能听(唤醒词 + 语音识别)、能说(喇叭播 TTS)、有记忆(录像 + 世界状态),隐私红线是画面和语音一律不出家门。
一周时间里,这条链路从零走到了端到端全通:喊"猫猫"它应答,问"现在几点"它回答,应答延迟从实测 12-16 秒压到 4.5 秒左右。然后我把它暂停了。这篇文章记录整个过程——协议怎么逆的、架构怎么被迫变形的、每一个 bug 长什么样、以及最后为什么停。如果你也想拿现成摄像头做 AI 语音入口,这些坑大概能帮你省掉最疼的那几天。
一、硬件盘点与能力边界
先把家底摆清楚,因为后面每一个架构决定都被它锁死:
| 设备 | 角色 | 关键约束 |
|---|---|---|
| 摄像头(NT98566) | 眼睛 + 耳朵 + 嘴巴 | RTSP 出音视频;对讲走厂商私有协议;同一时刻只服务一个对讲会话 |
| NAS(fnos) | 常驻算力节点 | 能直连摄像头 RTSP;到摄像头的"说话"通道全部不通(后详) |
| Jetson Thor 算力仓 ×2 | 模型服务层 | 跑 ASR / LLM / TTS / 向量库,内网 API 直连 |
| 微服沙箱 | 唯一能对摄像头说话的节点 | 与摄像头同属盒内网络;到 NAS 有 SSH 通道、无直连网络 |
模型选型全部走本地:唤醒词用 sherpa-onnx 自训关键词,VAD 用 Silero,ASR 用 SenseVoice(Whisper 兼容接口),LLM 是 vLLM 部署的 Qwen 3.5 4B,TTS 用 Kokoro。这条"三级算力金字塔"(摄像头 NPU → 小模型 → 大模型)的设计本身没问题,问题出在更底层的地方。
二、让摄像头开口:私有对讲协议逆向
厂商没有公开任何对讲 API,APP 里的"对讲"按钮就是唯一线索。抓包后确认它走一条 WebSocket,但直接连上去发音频帧,服务器毫无反应——必须先依次访问"预览页 → WebRTC 信令 → 状态接口"三个端点把 P2P 数据面从休眠中唤醒,再发对讲帧才会被受理。这个"裸发静默丢弃"的设计让我多花了一整晚:没有报错、没有拒绝,就是不响。
打通后的协议细节反而简单:音频帧是 320 字节的 G.711 A-law,正好 40ms;请求头里带一个盒内信任 ID;音量可以经 HTTP 接口设 0-100。TTS 侧的链路是 Kokoro 出 24kHz → 响度归一 → 重采样 8kHz → 低通 3.4kHz → 编 A-law → 按 40ms 一帧推。第一次听见摄像头用合成音说话的那一刻,这个项目最硬的一块骨头算是啃下来了。
代价随即显现:对讲会话是独占的。我们的喇叭会话会把手机 APP 的对讲挤掉,反之手机 APP 一用,我们的会话也断。于是我写了个"守门器"进程定时重建会话——这为后面的盲区问题埋了伏笔。
三、让摄像头听见:RTSP 音频与半双工的物理现实
听的通道比想象中坎坷。摄像头 RTSP 副流带音轨(G.711A 8kHz),但主流播放器库取音频要绕路,最后我按 RTP over TCP 的 interleaved 帧格式自己实现了解析器。上线后发现一个更隐蔽的坑:这个 RTSP 服务不发 RTCP 心跳,服务端大约 70 秒就把"不说话"的客户端踢掉。解法是断开时发规范的 TEARDOWN 释放会话表,加进程内自动重连,最终稳态是 72 秒监听 + 5 秒重连的循环,在线率约 93%。
更大的打击来自固件。一次 OTA 升级后,麦克风对 RTSP 和录像全程静音——所有链路代码一行没动,耳朵却聋了。这类"固件回归"是嵌入式设备的常态,后面会再遇到一次更致命的。
还有一条绕不过去的物理限制:这颗摄像头是半双工的,没有回声消除(AEC)。它自己说话时麦克风会录到自己,既可能自唤醒,也意味着"边听边说"永远做不到。商用音箱的丝滑全双工,靠的是芯片级 AEC + 波束成形,软件层补不了这一课。
四、被逼出来的双机架构
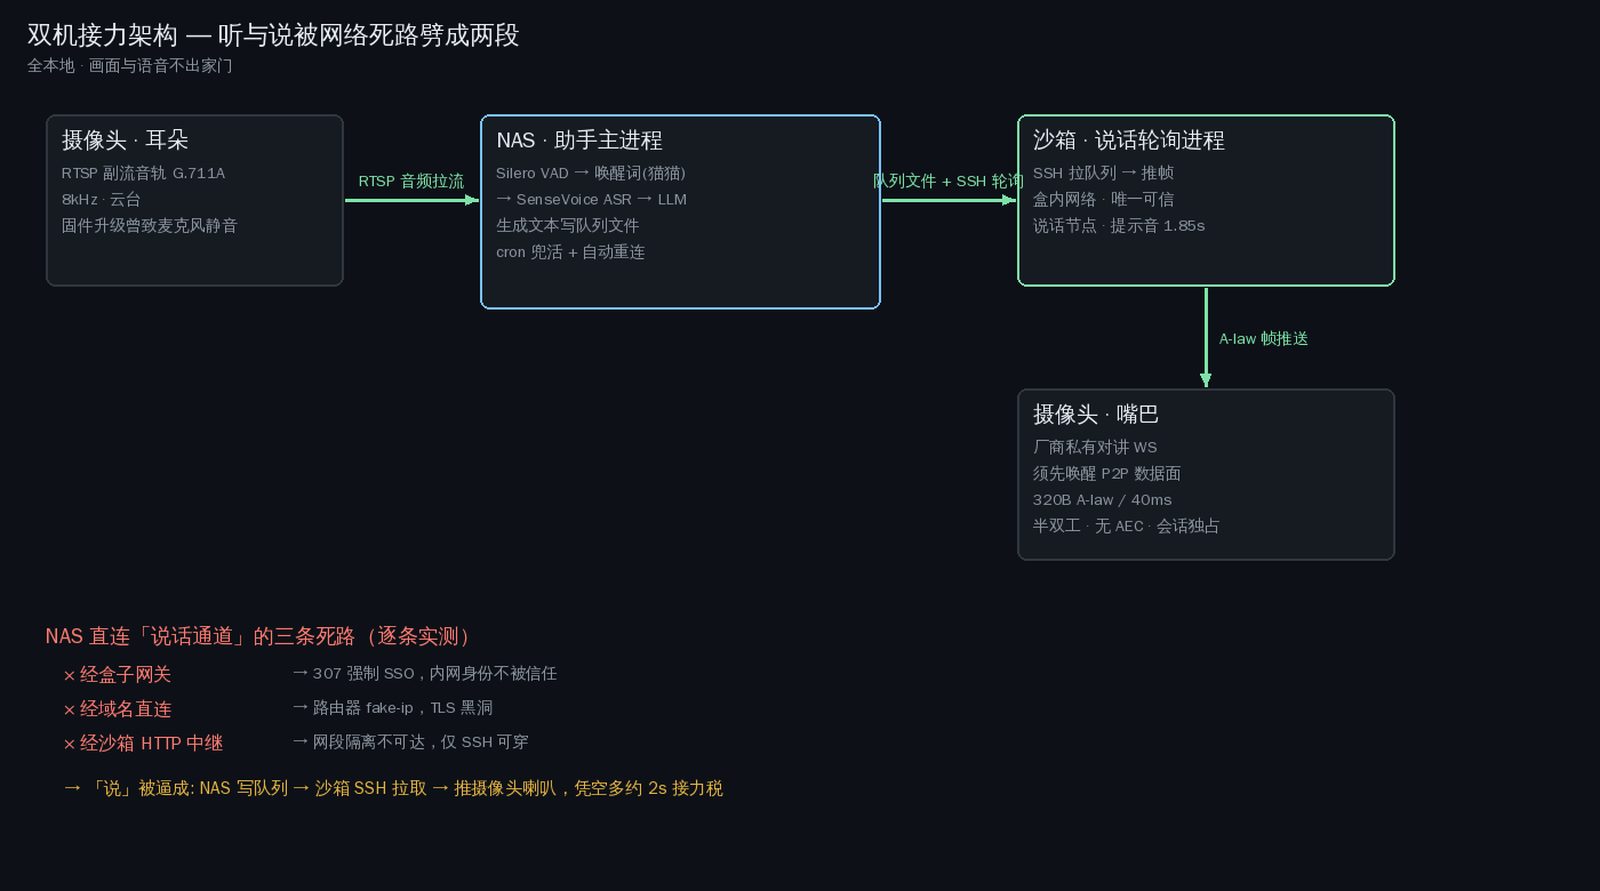
最戏剧性的一段。语音助手的主进程部署在 NAS 上(听 + 识别 + 生成),生成的话需要推给摄像头喇叭——然后我发现 NAS 到"说话通道"的所有路径全部走不通,逐条实测:
| 路径 | 结果 | 死因 |
|---|---|---|
| 经盒子网关直连对讲 WS | 307 跳转 | 网关强制 SSO 登录态,内网服务身份不被信任 |
| 经域名解析直连 | TLS 黑洞 | 路由器 fake-ip 模式下该域名根本不出真实地址 |
| 经沙箱 HTTP 中继 | 网络不可达 | NAS 与沙箱分属隔离网段,只有 SSH 能穿 |
结论:只有与摄像头同网络的沙箱能带信任头说话,而 NAS 只有 SSH 能到沙箱。于是架构被迫变成两段式——NAS 上的助手把要说的话写进队列文件,沙箱上的轮询进程经 SSH 复用连接拉取队列、再推给摄像头喇叭。功能上这没问题,端到端验证通过,但一次说话要跨两次进程接力、一条 SSH 隧道,凭空多了约 2 秒的"接力税",还多了一整面的故障域。这个税,是后面延迟优化的天花板之一。
五、延迟优化:实测打脸估计
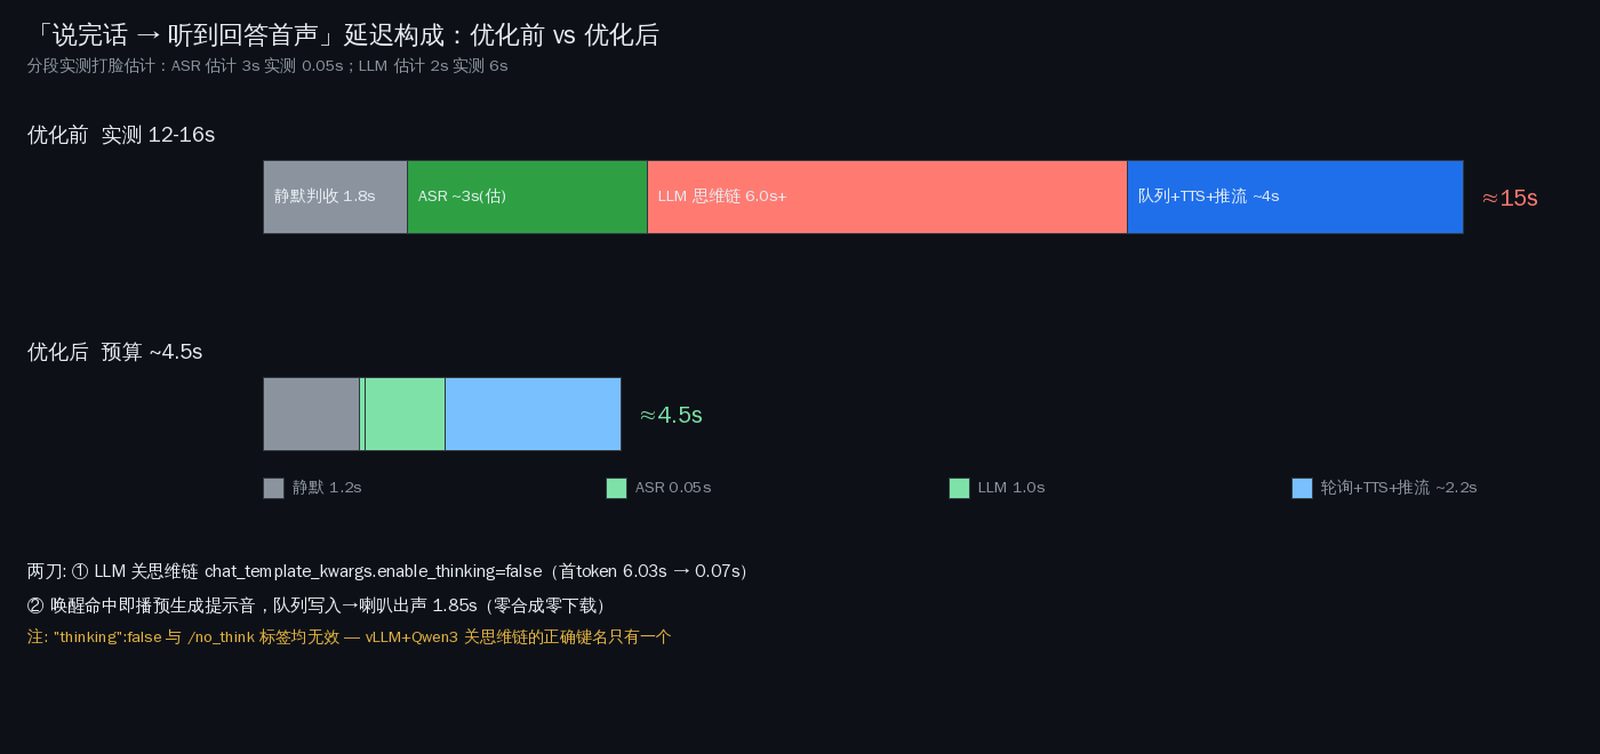
链路通了,但喊一声"猫猫"要等 12-16 秒才听到回答。优化前我先做了分段实测,结果直接推翻了方案里两个假设:
| 环节 | 方案里的估计 | 实测 | 结论 |
|---|---|---|---|
| ASR(5 秒音频) | ~3 秒 | 0.05 秒 | 内网 SenseVoice 快到可以忽略,"伪流式 ASR"方案直接砍掉 |
| LLM 首 token | ~2 秒 | 6.03 秒 | 真凶在这 |
| 队列接力 + TTS + 推流 | ~4 秒 | ~4 秒 | 符合预期,靠唤醒即时提示音缓解 |
LLM 为什么慢成这样?Qwen 3.5 默认开启思维链,回答正文之前先在 reasoning 字段里生成 1600 多字的内部推理。关掉它只要一个参数——但这个参数我踩了三步才踩对:"thinking": false 无效,prompt 里加 /no_think 标签也无效,正确写法是 chat_template_kwargs: {"enable_thinking": false}(vLLM 部署 Qwen3 系列的专用键名)。改完后首 token 从 6.03 秒降到 0.07 秒,全文生成 0.98 秒,一行参数砍掉全链路最大单点延迟。
另外两刀:唤醒词命中的瞬间不等任何识别,立即播一个预生成的双音提示(程序里常驻内存的 A-law 帧,零合成零下载),实测从队列写入到喇叭出声 1.85 秒,接近商用产品的"嗯哼"体感;静默判收从 1.8 秒压到 1.2 秒。"现在几点""今天几号"这类零歧义问句则本地模板直答,跳过 LLM。全部落地后,说完话到听到回答首声的预算约 4.5 秒。
六、bug 博物馆:这一周最值钱的部分
下面这些坑每一个都真实咬过人,按"疼的程度"排序。
1. Python 生成器陷阱:一行 yield 让整条音频流静默蒸发
最隐蔽的一个。从 RTSP 取音频的函数里有一条 ffmpeg 兜底路径,写的时候顺手用了 yield——于是整个函数被 Python 判定为生成器函数,函数末尾的 return gen() 不再是"返回生成器",而是"结束本生成器"。结果:RTSP 会话正常打开、零报错、日志一切正常,音频块在 0.1 秒内被静默丢弃。用户对着摄像头喊了半天"猫猫",系统其实一个字都没听到。
定位靠的是对照实验:同一段代码独立进程跑能出数据,塞进守护进程就是零块,最后 md5 双端比对排除部署差异,才盯到函数签名上。修法是把它重写成普通函数返回生成器。教训:含 yield 的函数里写 return 值,返回值会被直接吞掉,这类错误没有任何报错路径。
2. cron 兜活的三连坑
守护进程靠 crontab 每分钟检查拉活,但"检查活着"这件事本身错了三次:
- pgrep 自匹配:兜活命令的 shell 命令行里含模式串本身,pgrep -f 匹配到了 cron 的 shell 进程,永远判定"活着",从未拉起。修法是模式锚定进程绝对路径。
- 锚定过宽:锚定到虚拟环境解释器路径后,又匹配到了同一虚拟环境里的另一个守护进程,兜活再次失效。最终形态是"锚定路径 + 进程名单"双条件。
- SSH 会话杀进程组:手动起的守护,SSH 会话一断就被整组杀掉(nohup 也保不住)。结论:远程守护一律交给 cron 拉起,不要相信手动 nohup。
3. RTSP 服务挂死:一台"活着"的摄像头其实是聋的
某天用户再喊"猫猫",又没反应。排查发现 NAS 侧、探针侧对 8554 端口的所有连接全部"TCP 建立后立即重置"——摄像头本体没死(管理接口、Web UI、喇叭通道全部正常),是它里面的 RTSP 流媒体服务(HappyTime)单独挂死了,而且没有任何 watchdog 兜底。这个服务同时喂着录像,所以录像也是断的。
恢复过程又是一轮逆向。管理接口是 JSON-RPC,会话机制花了些功夫才摸清:登录成功的响应头里藏着一个 SessionId,后续请求必须带这个请求头——它不在 Cookie 里,用标准 cookie 处理拿不到。直接重启的 RPC 方法存在(dev_reboot),但参数格式试了 17 种形态全部被拒。最终走了一条曲线:设备信息里有"定时重启"字段(rebootDay / rebootHour),把它设成当天晚上 8 点,让设备自己重启修好自己,再由一次性脚本在重启后把设置还原成"never"。顺带在这轮逆向里意外挖到了云台预置位的完整 API——之前判断"这固件只有连续转动没有预置位"是错的,方法就躺在 Web UI 的 JS 里。
4. 零碎但真实的坑
- 装在 /tmp 下虚拟环境里的 ffmpeg 二进制被系统定期清理删掉,音频链路无声失效——二进制候选列表必须包含系统路径兜底。
- 说话轮询进程只扫描
say-*.json命名空间,我自己的测试文件起了别的名字,被静默忽略,制造了"进程不消费"的假象,白查半小时。 - 唤醒词"猫猫"的自训语料,音调标注必须是
m āo,写成mao识别率天差地别——中文唤醒词建模,声调是第一公民。 - 摄像头 RTSP 描述里支持的方法列表(DESCRIBE/SETUP/PLAY/TEARDOWN…)和实际行为不完全一致,以实测为准。
七、为什么最终暂停
链路是通的,延迟也压到了 4.5 秒,但我按了暂停键。三个原因,都是结构性的:
第一,双机架构是被死路逼出来的妥协,天花板明显。商用带屏音箱的响应是亚秒级,靠的是单芯片方案:DSP 级回声消除和波束成形、独立唤醒协处理器低功耗待机、全流式流水线(说话时识别已在并行推理、TTS 首包几百毫秒)、天然全双工。而我的架构里,"听"和"说"分居两台机器、靠文件队列和 SSH 轮询缝合,仅接力税就 2 秒,再怎么优化也到不了商用体感。
第二,可用性的根基不稳。固件升级会让麦克风静音回归;RTSP 服务会无监护挂死;对讲会话会被手机 APP 随时挤掉。每一次都是全链路瘫痪级别的事故,而我能做的只有打补丁式兜底。基础设施的可靠性不是应用层能补出来的。
第三,一个基础假设始终没有闭环:唤醒词的检出率我只用合成语音验证过,真实人声在真实距离、真实环境噪声下的表现从未系统测过。地基没验,楼盖得再漂亮也要打问号。
所以现状是:所有进程下线,摄像头还原成一颗普通摄像头(那晚 8 点它如约自愈重启,RTSP 恢复,定时重启设置已自动还原),代码、协议文档、实测数据全部入库留档。
八、给想做同类项目的人的清单
- 先验两端音频,再堆智能。喇叭协议能不能从你的算力节点可达?麦克风在流上是不是真的有声(测 RMS,别信"流在跑")?这两件事没闭环,后面全是沙上城堡。我顺序反了,代价是一整段返工。
- "能连"不等于"能长期连"。嵌入式设备的服务会静默挂死、会被固件升级弄聋、会踢空闲连接。一切外部依赖配 watchdog 和心跳告警,且要验证告警真的会响。
- 半双工设备做不了全双工管家。没有 AEC 的摄像头,说话时必须闭嘴听不见,交互体验的硬上限就在这。要对话体验,专用语音前端(哪怕几十块的 ESP32 类开源方案)远胜复用摄像头音频。
- 延迟优化先分段实测,别信估计。我的"ASR 3 秒"实测是 0.05 秒,"LLM 2 秒"实测是 6 秒——估计错得最离谱的地方,恰恰是优化收益最大的地方。另外记住 vLLM + Qwen3 关思维链的正确键名。
- Python 写流处理,盯死生成器。任何含 yield 的函数,return 的值都会被吞。流式管道尽量"普通函数返回生成器",并对"零数据"路径做显式断言。
- cron 兜活的模式串要防自匹配,锚定绝对路径还不够,同虚拟环境的其他守护会继续骗过它。
- 参考开源先行者:StreamAssist(Home Assistant 组件,与这条链路同构,"唤醒即播提示音掩盖处理延迟"的技巧直接可抄)、HA Assist Pipeline(四段全流式的参考实现)、go2rtc(很多摄像头盒子里就有它,值得先看看能不能走标准通道再逆向私有协议)、DeepCamera / llmvision / vigil(摄像头 + VLM 的事件理解与时间线问答)。
九、下一步
暂停不是终点。摄像头回归它的本职——"看":视觉事件理解加推送这条线已经验证过,稳定性和价值密度都更高。语音交互的下一站大概率是专用语音硬件:一颗带 AEC 和唤醒协处理器的开发板管听说,摄像头只管看,各司其职。协议逆向的成果、实测数据、全部代码都在仓库里躺着,等下一个决定。
如果这篇文章帮你避开了一个坑,它就值了。
← 返回博客列表 · 相关阅读:家庭安全中枢:自建 SIEM 的完整落地 · 家庭 LLM 集群的搭建与调优